Blogg
Cisco Data Fabric – Från utspridd maskindata till användbara insikter
Data finns överallt: i nätverk, säkerhetssystem, applikationer och moln. Men när informationen är splittrad och saknar sammanhang blir den svår att använda. Cisco Data Fabric bygger på Splunk-plattformen och knyter samman åtkomsten till distribuerad maskindata. Det kan förenkla felsökning, ge bättre kontroll över datakostnader och skapa bättre underlag för AI.

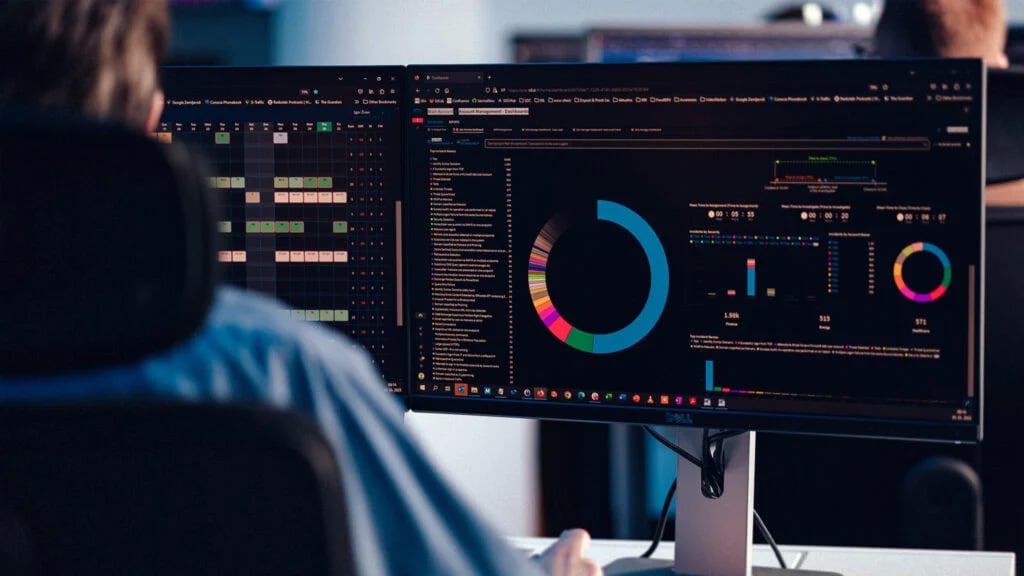
När data finns men sammanhanget saknas
Säkerhetsteam har sina larm, nätverksteam sin telemetri och utvecklingsteam sina loggar och spårningsdata. När ett problem berör flera delar av miljön måste någon sätta ihop helhetsbilden. Det tar tid och blir ännu viktigare när AI-assistenter och agenter ska använda informationen. De behöver relevant data, tydliga behörigheter och tillräckligt sammanhang för att ge användbara svar.
Splunks roll i Cisco Data Fabric
Ciscos nätverk, säkerhetssystem och infrastruktur producerar stora mängder telemetri. Splunk kan samla in, söka och analysera maskindata från många tekniska miljöer. Splunk-plattformen utgör grunden för Cisco Data Fabric, där data från Cisco, andra leverantörer och externa datakällor kan användas tillsammans.
Splunk-partner
Vad är Cisco Data Fabric
Cisco Data Fabric är en arkitektur som bygger på Splunk-plattformen, snarare än en separat produkt. Den knyter samman hantering, lagring, sökning och analys av distribuerad maskindata. Genom gemensamma möjligheter att hitta och använda information kan organisationer undersöka problem över systemgränser, utan att först samla all data på en central lagringsplats.
Gränsöverskridande insikter
Arkitekturen är relevant när ett drift- eller säkerhetsproblem berör flera team och system. En nätverksförändring kan till exempel behöva undersökas tillsammans med applikationsfel och inloggningshändelser. Splunk ger teamen en gemensam arbetsmiljö för undersökningen. För att informationen ska kunna kopplas ihop behöver datakällorna anslutas och relevanta fält, tidsstämplar och behörigheter hanteras.
Så hänger delarna ihop
Cisco Data Fabric kombinerar flera funktioner i Splunk-plattformen. Tillsammans gör de data tillgänglig utan att all information måste hanteras på samma sätt eller flyttas till en central plats.
- Data Management förbereder, bearbetar och styr data till rätt destination.
- Federated Search söker i externa datakällor som stöds, exempelvis Amazon S3, Snowflake och Azure Blob Storage, utan att först läsa in all data i Splunk.
- Machine Data Lake behåller stora mängder maskindata utan att allt behöver indexeras direkt. Utvalda delar kan föras över till Splunk-index eller analystabeller när de behövs.
- Catalog hjälper användare att hitta datamängder de har tillgång till och förstå dem genom metadata, exempelvis beskrivningar, fält och tidsomfattning.
Tillgängliga funktioner och anslutningar beror på Splunk-miljö, version, region och abonnemang.
Rätt balans mellan kostnad och prestanda
All data behöver inte samma sökprestanda. Information som används löpande för larm och felsökning kan indexeras, medan annan historik kan behållas mer kostnadseffektivt i Machine Data Lake. När en incident kräver djupare analys kan relevanta delar göras tillgängliga för mer avancerad bearbetning. På så sätt kan lagring och analys anpassas efter behov, i stället för att all data behandlas lika. Sökprestanda och analysmöjligheter varierar mellan de olika alternativen.
Vad betyder Cisco Data Fabric för AI?
En AI-assistent som ska hjälpa till vid ett applikationsfel behöver veta vilka händelser som är relevanta och vilket system de tillhör. Om den också ska föreslå en åtgärd behöver teamet kunna bedöma underlaget och förstå vilka befogenheter assistenten har.
Cisco och Splunk positionerar därför Data Fabric som en grund för AI-stödda arbetsflöden. Nyttan kommer från relevant data som är sökbar, begriplig och tillgänglig med rätt behörigheter. Större datamängder ger inte automatiskt mer precisa svar. Datakvalitet, sammanhang och utformningen av arbetsflödet är avgörande, och graden av automatisering behöver bedömas för varje användningsfall.
AI-säkerhet
Börja med ett konkret problem
Börja med ett avgränsat problem där data från flera miljöer behövs. Det kan vara en incident som kräver äldre historik eller felsökning där nätverk och applikationer behöver analyseras tillsammans. Avgör sedan vilken data som behöver vara indexerad för snabb och återkommande sökning, vilken historik som kan lagras i Machine Data Lake och vilka externa källor som behöver nås. Bestäm även vem som ansvarar för datan och vilka som ska få använda den.
Vad Cisco Data Fabric kan betyda för IT-avdelningen
Snabbare felsökning. Gemensam sökning och analys kan minska arbetet med att hitta och sammanställa information från flera system.
Bättre underlag för AI. Relevant data med sammanhang och styrd åtkomst ger bättre förutsättningar för användbara AI-stödda analyser och rekommendationer.
Bättre samarbete. Säkerhets-, nätverks- och driftteam kan arbeta utifrån gemensamma underlag i sina undersökningar.
Mer flexibel dataekonomi. Lagring och bearbetning kan anpassas efter hur ofta data används. Samt vilken prestanda som behövs.
Observabilitet
Om författaren

Mattias Lundström
Solution Architect
Med över 30 år i IT-branschen har Mattias Lundström följt utvecklingen från tidiga datasystem till dagens AI-drivna plattformar för säkerhet och observabilitet. I rollen som Solution Architect hjälper Mattias både kunder och säljteam att ta fram rätt lösningar inom de plattformar han arbetar med.
Relaterat