Blogg
Så fungerar Cisco Data Fabric – från lagring till analys
Data finns överallt, men värdet uppstår först när rätt information går att hitta, analysera och använda när den behövs. Cisco Data Fabric hjälper organisationer att samla, söka och hantera maskindata över flera miljöer utan att tappa kontroll över kostnader eller komplexitet. Här går vi igenom hur arkitekturen fungerar och hur den kan ge ett bättre underlag för säkerhet, drift och AI-driven analys.


För att förstå hur Cisco Data Fabric skapar den här flexibiliteten behöver vi titta närmare på de olika komponenterna. Arkitekturen bygger på att data kan lagras, sökas och analyseras på olika sätt beroende på verksamhetens behov, utan att all information måste flyttas till samma plats.
Vad är Cisco Data Fabric?
Så hänger Data Fabric-delarna ihop
Cisco Data Fabric ska göra maskindata tillgänglig och användbar över flera miljöer. Viss data indexeras direkt i Splunk för återkommande sökningar och snabba undersökningar. Annan data behålls i Machine Data Lake, där relevanta delar vid behov kan väljas ut och göras tillgängliga i ett Splunk-index eller en analystabell. Data i externa källor som stöds, till exempel Amazon S3, Snowflake och Azure Blob Storage, kan nås genom Federated Search utan att först indexeras i Splunk.
De centrala delarna har olika uppgifter:
- Data Management förbereder och styr data till rätt destination. AI-stödd onboarding kan hjälpa administratören att identifiera schema och fält samt ta fram konfiguration som går att granska.
- Federated Search gör det möjligt att söka i externa datakällor som stöds utan att först kopiera allt till Splunk. Vilka sökningar som går att göra beror på källan och den konfigurerade integrationen.
- Machine Data Lake behåller maskindata för längre historik och gör det möjligt att föra över utvalda delar till analys när behovet förändras. Kunden kan därmed väga snabb åtkomst mot kostnaden för att behålla data.
- Catalog visar datamängder som användaren har behörighet till, bland annat Splunk-index, federerade datamängder och Machine Data Lake-data. Tillgänglig information om innehåll, schema och tidsomfattning hjälper användaren att välja rätt underlag.
- Splunks analysfunktioner och arbetsflöden använder data för undersökningar, korrelation, dashboards, rapportering och larm inom bland annat säkerhet och drift.
- AI-funktioner, däribland Agent Launchpad, ger stöd för agenter och återanvändbara färdigheter i arbetet med data. Nyttan beror på vilket underlag och vilka verktyg agenten får använda.
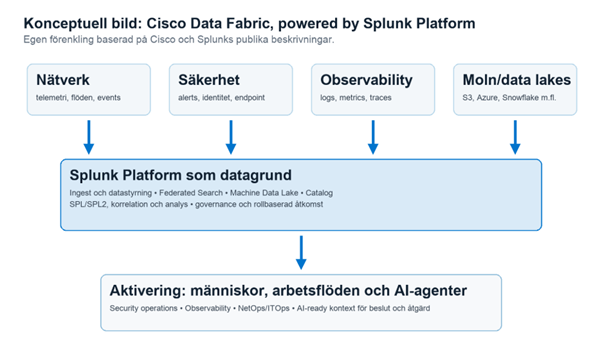
Figur 1. Konceptuell översikt, inte en karta över tillgänglighet. Pilarna visar logiska samband och innebär inte att all data måste flyttas till Splunk.
Lagring och analys efter behov
Värdet av maskindata förändras över tid. En loggström som verkar rutinmässig i dag kan bli viktig vid en senare incident eller revision. Machine Data Lake är avsett för bredare och längre lagring, medan data som kräver snabb analys bör finnas i ett Splunk-index. Med Catalog och Federated Search kan användaren också hitta och nå data som finns på andra platser.
Vid en incident kan säkerhetsteamet hitta äldre nätverksloggar i Catalog, välja berörda värdar och tidsintervall och föra över just dessa händelser till ett Splunk-index. Där kan de analyseras tillsammans med aktuella händelser. På så sätt kan analys och lagring, och därmed kostnaden, anpassas efter hur snabbt datan behöver vara tillgänglig.
Vad det betyder för kunder och partners
Cisco Data Fabric ger en gemensam arkitektur för hur maskindata kan användas i säkerhetsarbete, observabilitet och drift. För kunder och partners innebär detta en möjlighet att arbeta smidigare och mer effektivt. Värdet ligger i att kunna besvara viktiga frågor snabbare, med mindre manuellt arbete, och ett bättre underlag.
Tillgänglighet och förutsättningar
Tillgängligheten varierar mellan funktionerna i Cisco Data Fabric. För tillfället är Machine Data Lake och Catalog tillgängliga i Splunk Cloud Platform i regionerna US-East, Frankfurt, Tokyo och Sydney. Funktionerna kräver en stödd version och att tjänsten är aktiverad för kundens miljö. Inför ett införande behöver därför region, abonnemang och stöd för aktuella datakällor kontrolleras.
Observabilitet
Från teori till praktik
Cisco Data Fabric är inte bara en vision: det är en praktisk lösning för att göra data tillgänglig, sökbar och användbar på ett sätt som stödjer både dagligt arbete och avancerad AI-analys. Genom att kombinera Data Management, Federated Search, Machine Data Lake och Catalog skapas en arkitektur som anpassar sig efter dina behov: snabb åtkomst till kritisk data, kostnadseffektiv lagring för historisk information, och sökbarhet över externa källor.
Ett första steg är att välja en datakälla och en konkret fråga som verksamheten behöver kunna besvara. Men glöm inte kontrollera vilka funktioner som finns tillgängliga i er Splunk-miljö och hur data bäst ska lagras och analyseras för det behovet.
Om författaren

Mattias Lundström
Solution Architect
Med över 30 år i IT-branschen har Mattias Lundström följt utvecklingen från tidiga datasystem till dagens AI-drivna plattformar för säkerhet och observabilitet. I rollen som Solution Architect hjälper Mattias både kunder och säljteam att ta fram rätt lösningar inom de plattformar han arbetar med.
Relaterat